API-uri de mare capacitate: cum răspunzi rapid când traficul se înmulțește
Ghid practic pentru API-uri care rămân rapide sub încărcare: latență p95 și p99, cache, paginare, cozi, rate limiting, idempotență și teste de încărcare, cu exemple concrete.
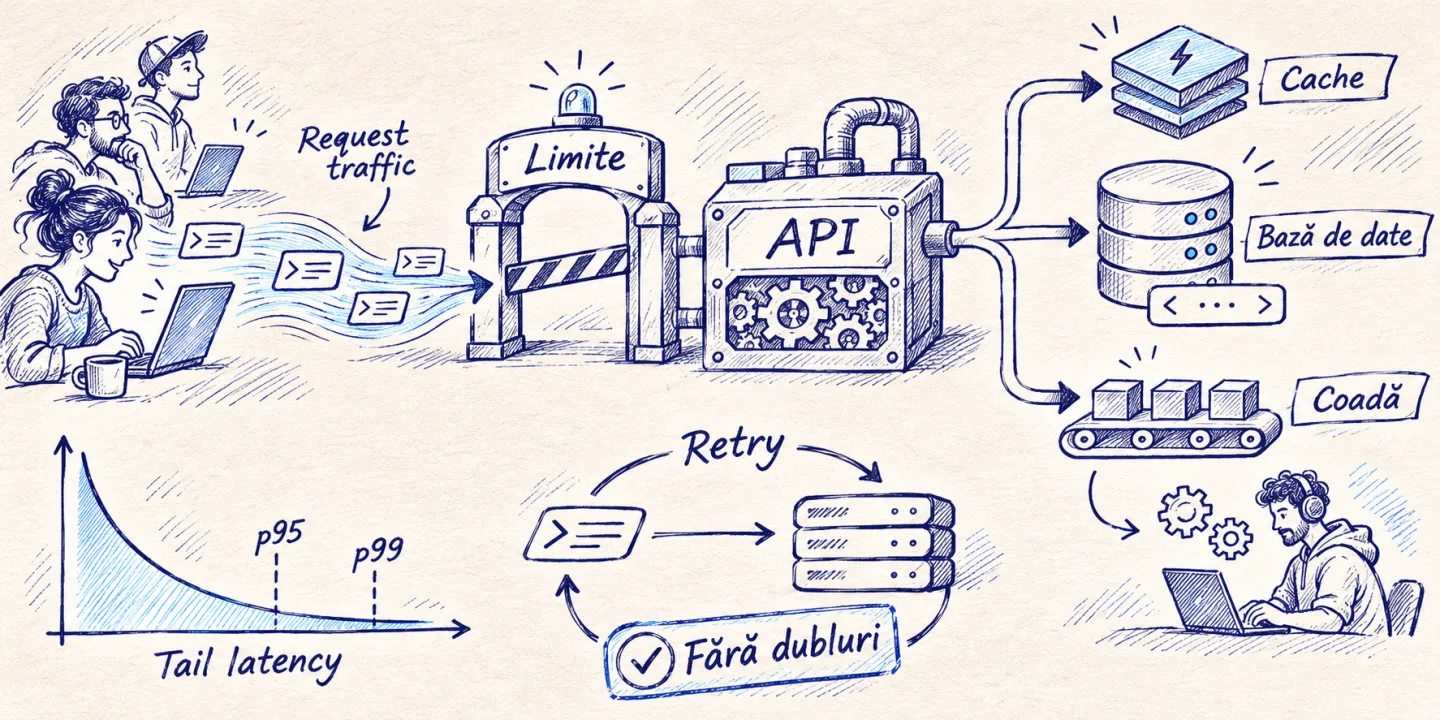
Un API merge bine cât timp îl folosesc zece oameni. Problemele apar când vine o campanie, o integrare nouă sau un partener care trimite cereri în rafală, iar timpul de răspuns trece de la 80 de milisecunde la patru secunde. Vestea bună: majoritatea blocajelor se repetă de la un proiect la altul și se rezolvă cu un set de practici cunoscute. În articol parcurg ce măsori, unde se pierde timpul și ce poți face, în ordinea în care aș face-o eu.
Pe scurt
- Măsoară percentilele (p95, p99), nu media. Utilizatorii își amintesc cererea cea mai lentă.
- Cele mai multe câștiguri vin din baza de date: interogări mai puține, indexuri potrivite, rezultate puse în cache.
- Ce nu trebuie făcut în timp ce clientul așteaptă se mută într-o coadă și se procesează în fundal.
- Limitele (rate limiting, timeout-uri, dimensiune maximă) protejează sistemul de propriii clienți.
- Fără teste de încărcare rămâi cu presupuneri. Un test făcut o dată pe trimestru valorează mai mult decât orice estimare.
Începe cu măsurarea, nu cu optimizarea
Prima întrebare nu este „cum îl fac mai rapid?”, ci „cât de rapid este, pentru cine și când?”. Media timpilor de răspuns minte. Dacă 95 din 100 de cereri durează 100 ms și 5 durează 5 secunde, media arată 345 ms, adică „în regulă”, dar unul din douăzeci de utilizatori a așteptat prea mult.
De aceea urmărești percentile:
- p50 (mediana): experiența tipică.
- p95: ce simte unul din douăzeci de utilizatori.
- p99: coada lungă, unde apar cele mai neplăcute surprize și, de obicei, cele mai interesante cauze.
Pe lângă latență, urmărești rata de erori, numărul de cereri pe secundă și saturarea resurselor (procesor, memorie, conexiuni la baza de date). Împreună îți spun dacă sistemul are încă loc de respirat sau este aproape de limită.
Un obiectiv explicit ajută: „p95 sub 300 ms pentru endpoint-urile de citire, sub 800 ms pentru cele de scriere, 99,9% cereri reușite”. Fără el, orice discuție despre performanță devine o părere.
Baza de date este, de obicei, vinovatul
Când un API încetinește, în aproape toate proiectele văd aceeași ordine a cauzelor: baza de date, apoi apelurile către alte servicii, abia la urmă codul propriu-zis. Câteva probleme clasice:
Problema N+1. Aduci o listă de 50 de comenzi, apoi pentru fiecare comandă faci o interogare separată pentru client. Ai 51 de interogări acolo unde ar fi fost suficiente două. Se rezolvă prin încărcarea relațiilor dintr-o dată (join sau interogare grupată).
Indexuri lipsă. O interogare pe un câmp neindexat parcurge tot tabelul. Merge bine cu 1.000 de rânduri și se prăbușește la 5 milioane. Majoritatea bazelor de date au un instrument de analiză a planului de execuție (de exemplu EXPLAIN) care îți arată exact unde se citește tot tabelul.
Câmpuri aduse degeaba. SELECT * pe un tabel cu coloane mari (texte lungi, JSON) transferă date pe care răspunsul nici nu le folosește. Ceri doar ce trimiți.
Conexiuni. Fiecare cerere care deschide o conexiune nouă plătește un cost de câteva zeci de milisecunde, iar baza de date acceptă un număr limitat de conexiuni simultane. Un pool de conexiuni, dimensionat cu cap, rezolvă ambele probleme.
Pentru citiri frecvente cu date care se schimbă rar (cataloage, setări, liste de prețuri), cele mai mari câștiguri vin din cache.
Cache: ce, unde și cât timp
Cache-ul este cea mai puternică și cea mai periculoasă unealtă. Puternică, pentru că o cerere servită din memorie costă microsecunde. Periculoasă, pentru că datele vechi servite cu încredere produc bug-uri greu de depistat.
O ierarhie practică, de la client spre server:
- Cache în browser și CDN, controlat prin antetele
Cache-ControlșiETag. Răspunsurile publice și identice pentru toți (liste de produse, articole) pot fi servite fără să mai ajungă la serverul tău. - Cache de aplicație (de exemplu Redis): rezultatele interogărilor costisitoare, păstrate secunde sau minute.
- Cache în baza de date și vederi materializate pentru rapoarte grele.
Regula care te scutește de probleme: decizi de la început cum se invalidează. Ai două strategii simple. Prima, expirare după timp (TTL): „această listă poate fi veche cel mult 60 de secunde”. A doua, invalidare la scriere: când se modifică un produs, ștergi intrarea lui din cache. Pentru multe cazuri, o combinație dintre ele este suficientă.
Un exemplu de antet pentru o resursă publică ce poate sta 60 de secunde în cache, cu 5 minute de toleranță în timp ce se reîmprospătează în fundal:
Cache-Control: public, max-age=60, stale-while-revalidate=300
ETag: "a1b2c3"
Atenție la datele personalizate: răspunsurile care depind de utilizator nu se pun în cache public, altfel un client poate primi datele altuia. Pentru ele folosești private sau le excluzi complet.
Paginare și răspunsuri cu dimensiune controlată
Un endpoint care returnează „toate comenzile” funcționează în testare și cedează în producție, când există 200.000. Orice listă are nevoie de paginare, iar alegerea contează:
| Metodă | Cum funcționează | Când o alegi |
|---|---|---|
Offset (?page=3) |
Sare peste N rânduri | Liste mici, interfețe cu număr de pagină |
Cursor (?after=id) |
Continuă de la ultimul element văzut | Liste mari, derulare continuă, date care se schimbă |
Paginarea cu offset încetinește pe măsură ce mergi în adâncime, pentru că baza de date numără și aruncă rândurile sărite. Paginarea cu cursor rămâne constantă și nu produce dubluri când apar elemente noi. Pentru API-uri publice sau cu volum mare, o recomand implicit.
Adaugă o dimensiune maximă a paginii (de exemplu 100) pe care clientul nu o poate depăși, chiar dacă o cere. Același principiu se aplică pentru dimensiunea corpului cererilor primite.
Ce nu trebuie făcut sincron, se face în coadă
Multe endpoint-uri lente fac prea multe lucruri înainte să răspundă: trimit e-mailuri, generează PDF-uri, recalculează statistici, apelează trei servicii externe. Clientul așteaptă tot timpul acesta, iar un singur serviciu extern lent îți ține în loc toate cererile.
Modelul sănătos: API-ul validează cererea, o salvează, pune o sarcină într-o coadă (Redis, RabbitMQ, SQS etc.) și răspunde imediat cu 202 Accepted și un identificator. Un proces separat (worker) execută sarcina. Clientul află rezultatul printr-un endpoint de stare sau printr-un webhook.
Avantajele sunt multiple: răspunsuri rapide, sarcini care pot fi reluate dacă eșuează, capacitate ce se scalează independent (adaugi workeri fără să atingi API-ul) și un tampon care absoarbe vârfurile de trafic. Dacă vin 10.000 de cereri într-un minut, coada le ține și workerii le procesează în ritmul lor.
Limite: protejează sistemul de propriii clienți
Un client cu o buclă greșită poate dărâma un API întreg, fără nicio intenție rea. Limitele sunt plasa ta de siguranță:
- Rate limiting. Un număr maxim de cereri pe minut pentru fiecare cheie de API sau adresă IP. La depășire răspunzi cu
429 Too Many Requestsși antetulRetry-After, care îi spune clientului când să reîncerce. - Timeout-uri peste tot. Fiecare apel către bază de date sau serviciu extern are o limită de timp. Fără ea, o dependență blocată blochează lanțul întreg.
- Întrerupător de circuit (circuit breaker). Dacă un serviciu extern eșuează repetat, nu mai este apelat o vreme, iar API-ul răspunde cu o variantă de rezervă sau cu o eroare clară, în loc să se târască.
- Degradare controlată. Când sistemul este sub presiune, oprești întâi funcțiile secundare (recomandări, statistici) și păstrezi nucleul (comenzi, plăți).
Idempotența: reîncercările fără dubluri
Într-un sistem distribuit, cererile se pierd și clienții reîncearcă. Dacă o plată a fost trimisă, răspunsul s-a pierdut pe drum, iar clientul retrimite cererea, riști să încasezi de două ori. Soluția este idempotența: aceeași cerere, trimisă de mai multe ori, produce un singur efect.
Practic, pentru operațiile care modifică date, clientul trimite o cheie unică (Idempotency-Key). Serverul o memorează împreună cu rezultatul. La o reîncercare cu aceeași cheie, returnează rezultatul salvat în loc să execute din nou operația. Este un detaliu mic de implementat și te scutește de unele dintre cele mai costisitoare incidente.
Scalare: întâi mai bine, apoi mai mult
Reflexul este să adaugi servere. Merge, dar costă și mută problema. Ordinea pe care o urmez:
- Elimini munca inutilă: interogări în plus, câmpuri aduse degeaba, serializări repetate.
- Adaugi cache acolo unde datele permit.
- Muți în fundal ce nu trebuie făcut în timpul cererii.
- Scalezi orizontal serviciul, cu mai multe instanțe fără stare în spatele unui load balancer. Sesiunile se țin în afara instanței (Redis, token-uri), altfel o instanță nouă nu poate prelua utilizatorul.
- Scalezi baza de date: replici de citire pentru interogări grele, partiționare sau separare pe domenii abia când este nevoie reală.
Fiecare pas costă mai mult decât precedentul în complexitate. Cu primii trei se rezolvă, în experiența mea, marea majoritate a cazurilor întâlnite la IMM-uri și la produse în creștere.
Testează încărcarea înainte să o facă utilizatorii
Un test de încărcare simulează trafic realist și arată unde cedează sistemul. Unelte precum k6, Locust sau Gatling fac asta fără mult efort. Un scenariu util are patru faze: încălzire, creștere treptată, platou la nivelul așteptat și un vârf de două-trei ori mai mare, ca să vezi cum se degradează.
Ce urmărești în timpul testului: la ce număr de cereri pe secundă p95 trece de obiectiv, ce resursă se saturează prima și cum se comportă sistemul la depășire (încetinește treptat sau cade brusc). Răspunsul la ultima întrebare este cel mai valoros. Un sistem care încetinește treptat și îți dă timp să reacționezi este mult mai bun decât unul care cade fără avertisment.
Rulează testul într-un mediu cât mai apropiat de producție și repetă-l după schimbări mari. Rezultatele vechi nu se aplică arhitecturii noi.
Concluzie
Un API rapid sub presiune nu cere tehnologii exotice, ci disciplină: măsori percentilele, cureți interogările, pui în cache cu o strategie de invalidare, muți munca grea în fundal, pui limite, faci operațiile idempotente și testezi încărcarea. Aplicate în ordine, aceste practici duc un API de la „merge cât timp nu îl folosește nimeni” la „rămâne previzibil când are succes”.